¿Y si el futuro de la IA en backend no es generar texto? Conociendo a Jev y los modelos 'System One'
Un profundo análisis del nuevo modelo de IA, Jev, y su innovador enfoque 'System One' que promete redefinir el procesamiento estructurado en arquitecturas de software modernas.
Todos los que hemos intentado integrar un LLM en un pipeline de backend conocemos exactamente esta sensación:
Escribes un prompt larguísimo, activas el modo JSON (structured_outputs o herramientas similares), envuelves la llamada en un try/catch cargado de fe y cruzas los dedos para que:
- El modelo no decida inventarse una propiedad nueva fuera del esquema.
- La respuesta no tarde 6 segundos mientras el usuario mira un spinner eterno.
- El coste en tokens de salida no se dispare simplemente para devolver un booleano o un enum de tres opciones.
La respuesta no determinista o probabilística de los modelos tradicionales hacen que sea una tarea compleja para los desarrolladores de backend para implementar soluciones robustas y escalables. Usar la AI en el backend definitivamente requiere un salto de fe, y aunque en la mayoría de casos funciona, creo que a tonos nos a pasado que en alguna respuesta simplemente no responde como debería.
Durante los últimos dos años, la industria ha tratado a los modelos de lenguaje autorregresivos como navajas suizas. Si necesitabas enrutar un ticket de soporte, validar una transacción sospechosa o clasificar la intención de un usuario, la respuesta por defecto era: “Mándaselo a GPT-4o o a Claude en un JSON”.
Pero seamos sinceros: usar un modelo de 100B+ parámetros diseñado para escribir sonetos y razonar código complejo solo para decidir si un mensaje es spam o no, suele sentirse como usar un lanzallamas para encender una vela.
Hace poco, el equipo de TypeSafe AI (liderado por Diogo Almeida, ex-OpenAI) presentó Jev, inaugurando lo que denominan System One Models. Y la propuesta me parece una de las ideas más refrescantes y sensatas que he visto en mucho tiempo en infraestructura de software.
La premisa: Renunciar por completo a los strings
La genialidad de Jev no está en lo que agrega, sino en lo que quita.
Un LLM tradicional es esencialmente un generador de texto: predice token por token de manera secuencial. Si le pides un JSON, internamente sigue escribiendo texto carácter a carácter ({, ", s, t, a, t, u, s, …).
Jev rompe con esto por diseño: no genera strings libres.
La arquitectura funciona como una función pura con garantías de tipos:
- Entrada: Contexto no estructurado (texto libre, logs, emails, datos desordenados).
- Esquema: Una definición estricta de salida (tipos, enums, booleanos).
- Salida: Una decisión que satisface matemáticamente el esquema, sin pasar por una etapa intermedia de texto libre.
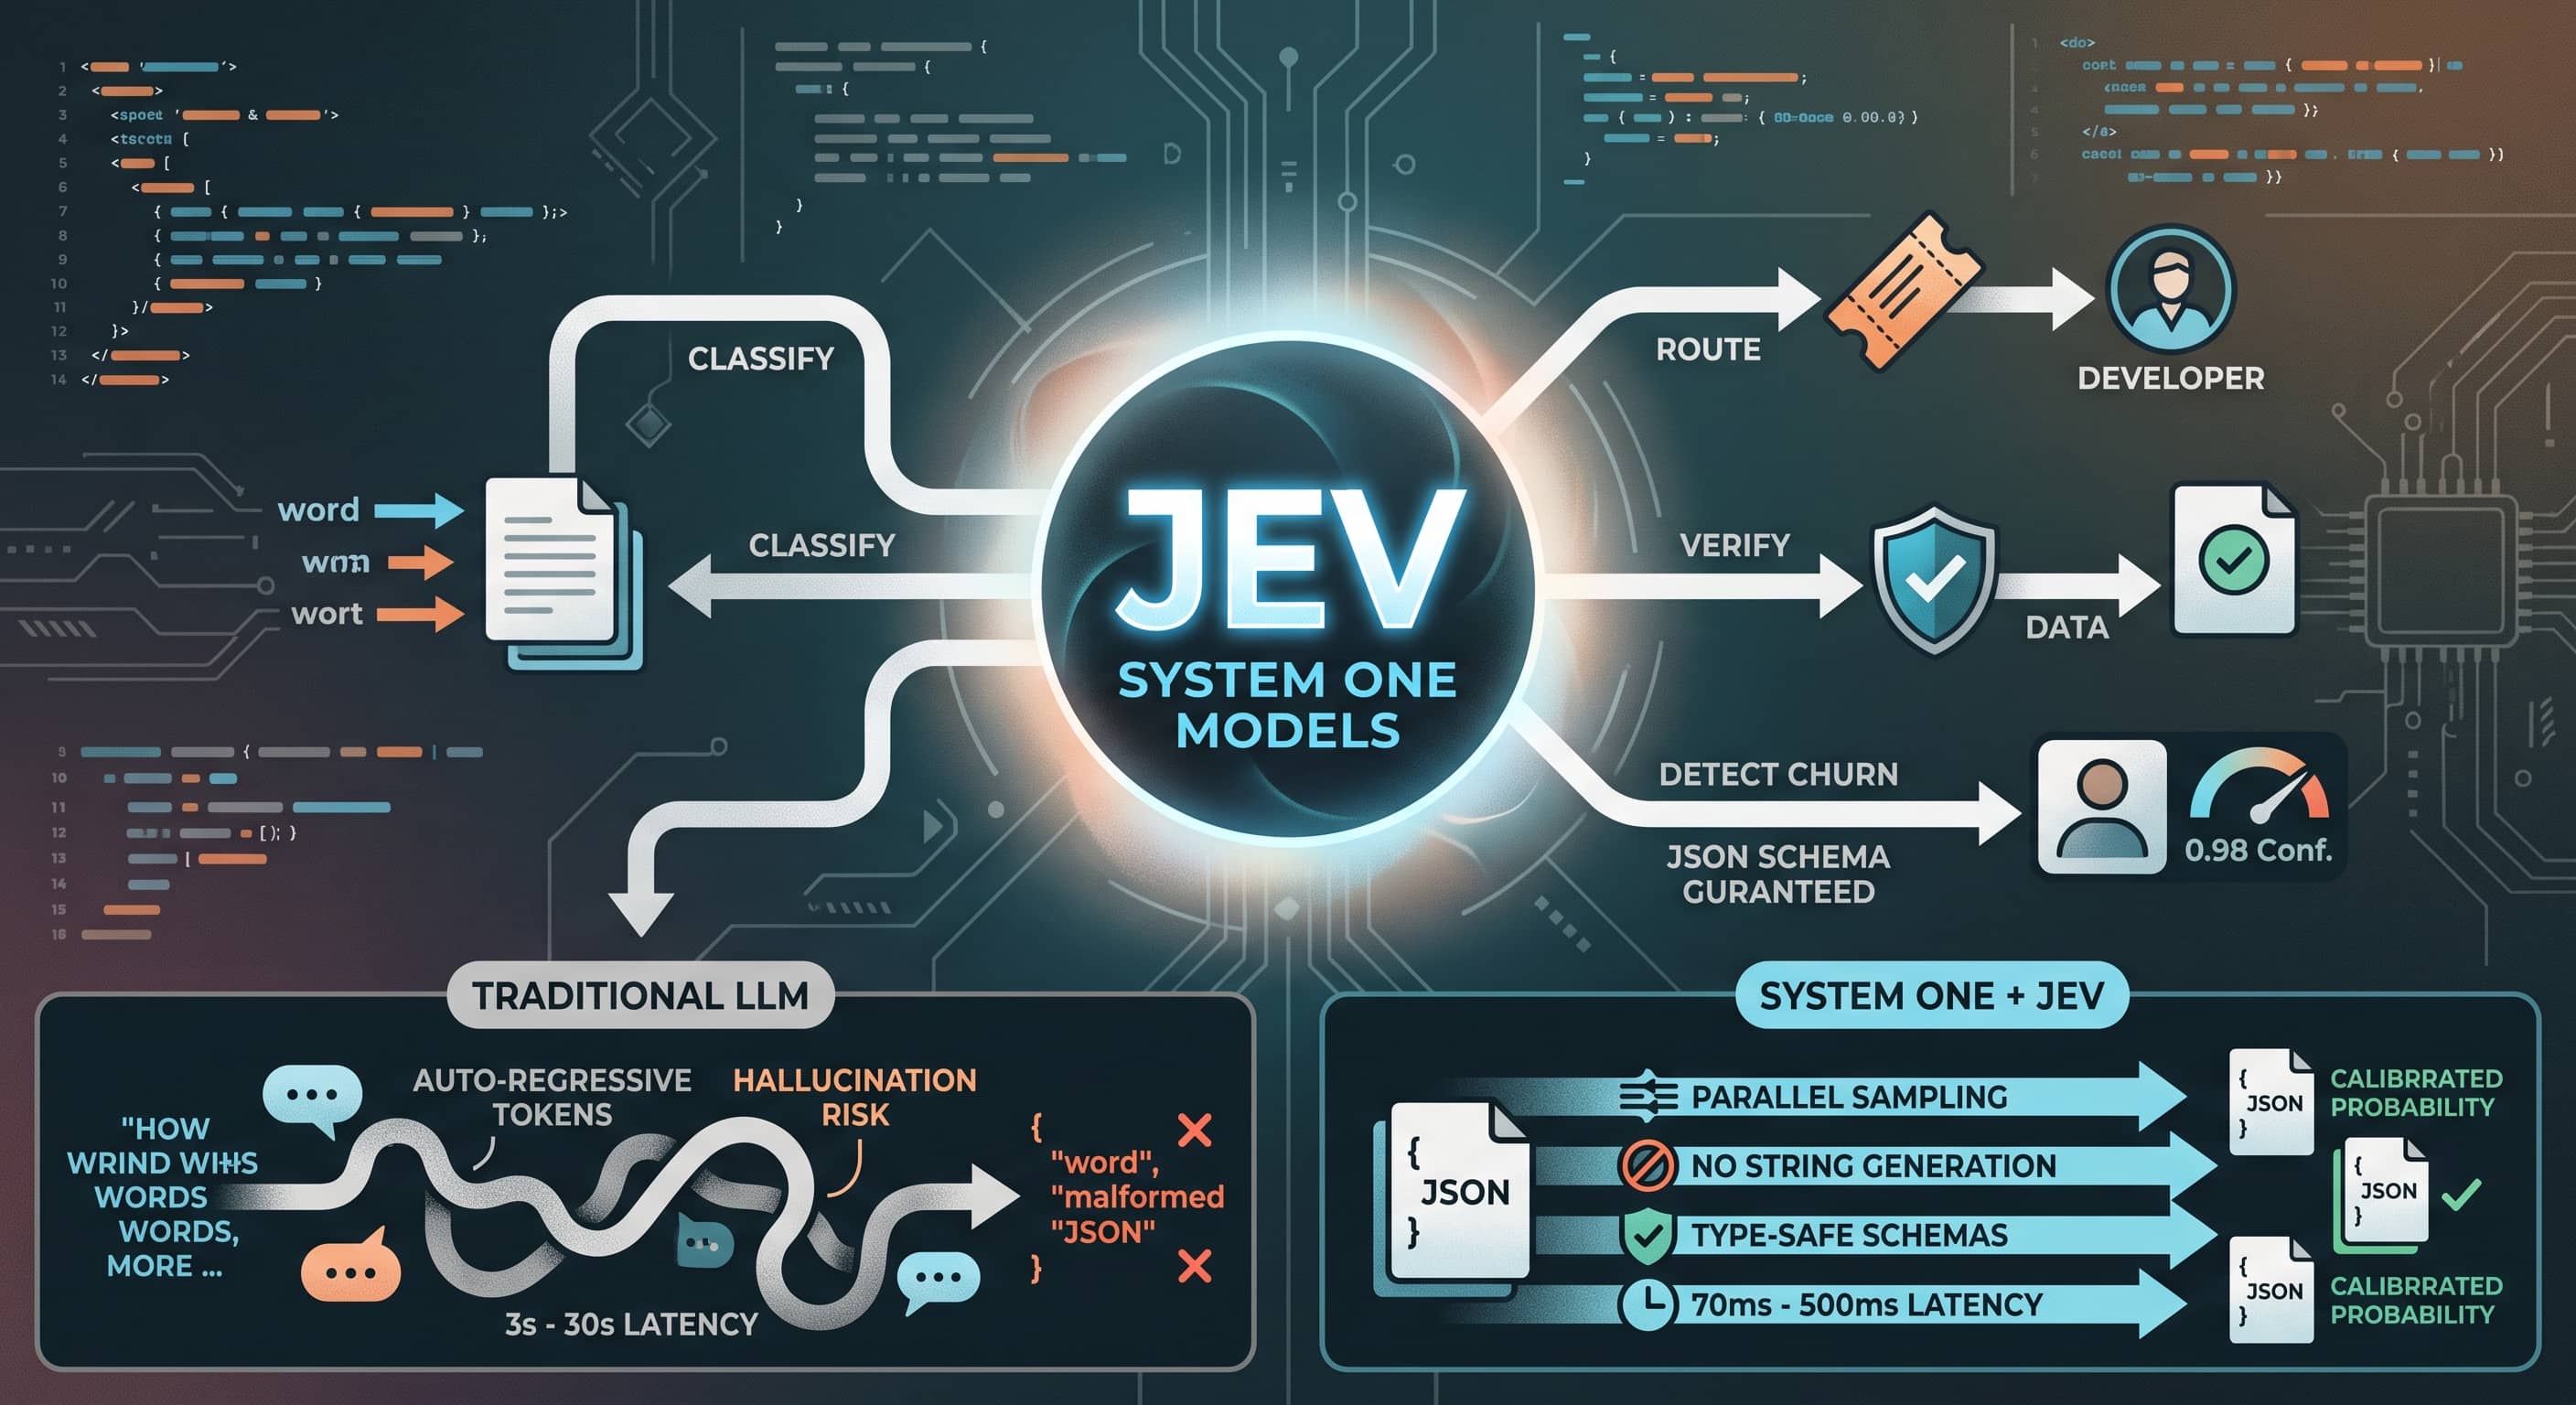
Al eliminar la generación de strings, desaparecen los dos mayores dolores de cabeza de los desarrolladores: no hay alucinaciones de formato y no hay parsers rotos en runtime.
Vuelve un poco más determinista y predecible el uso de la IA, algo que los desarrolladores de backend agradeceremos.
¿Por qué esto importa tanto para producción?
1. Latencias reales para APIs síncronas (70ms – 500ms)
El cuello de botella de los LLMs siempre ha sido la naturaleza autorregresiva: para escupir 100 tokens, el modelo debe hacer 100 pasadas hacia adelante en la red neuronal.
Al evaluar directamente probabilidades sobre un árbol de decisión predefinido (muestreo en paralelo), Jev reduce los tiempos de respuesta al rango de los 70ms a 500ms. De pronto, meter inteligencia probabilística dentro del ciclo de vida de una petición HTTP síncrona ya no destruye tus SLAs.
2. Confianza matemáticamente calibrada (RLCD)
Los LLMs estándar están entrenados con RLHF (aprendizaje por refuerzo con feedback humano). ¿El efecto secundario? Tienden a ser complacientes y sonar absurdamente seguros incluso cuando están totalmente equivocados.
Jev utiliza RLCD (Reinforcement Learning for Calibrated Decisions). En lugar de optimizar para sonar convincente ante un humano, el modelo optimiza para calibración epistémica. Si el modelo te dice que hay un $87%$ de certeza de que una transacción es fraudulenta, ese porcentaje representa una probabilidad matemática real, permitiéndote definir umbrales de seguridad en código:
const decision = await jev.evaluate({
  input: incomingRequest,
  schema: RiskAssessmentSchema,
});

// Puedes confiar en los umbrales porque están calibrados
if (decision.confidence > 0.85 && decision.value === "HIGH_RISK") {
  await triggerManualReview(incomingRequest);
}
3. Costes predecibles
Al no haber generación de tokens de salida, TypeSafe AI cobra únicamente por los tokens de entrada ($0.042 por millón de tokens). El output es efectivamente gratis a nivel de computación de tokens.
”Sistema 1” vs. “Sistema 2”: El rol de cada herramienta
El nombre no es casualidad. Viene de la distinción psicológica de Daniel Kahneman (Thinking, Fast and Slow):
- System 1 (Rápido, intuitivo, automático): Reconocer un patrón, frenar ante un semáforo en rojo, clasificar una emoción. Esto es Jev.
- System 2 (Lento, deliberativo, analítico): Resolver un problema matemático complejo, escribir un ensayo, planificar la arquitectura de un sistema. Esto son los LLMs tradicionales (como o1, Claude 3.5 Sonnet o GPT-4o).
Jev no compite contra Claude ni contra GPT-4o para escribir código o ayudarte a pensar. Es una pieza de plomería técnica. Es ese “if-statement inteligente” que colocas en tu backend para clasificar, filtrar y derivar flujos antes de invocar (o no) procesos más pesados.
Las dudas y retos que quedan abiertos
Aunque la propuesta sobre el papel es brillante, como ingenieros conviene mantener una dosis saludable de escepticismo técnico:
- Escalabilidad de esquemas complejos: ¿Cómo se comporta el modelo cuando el esquema de salida deja de ser un enum simple de 4 opciones y pasa a ser un grafo anidado con decenas de ramas?
- Ecosistema cerrado: La dependencia de un proveedor específico para una primitiva de infraestructura siempre es un factor de riesgo en arquitectura frente a estándares abiertos o pesos descargables.
- Casos frontera: Habrá que ver qué tan bien generaliza el modelo cuando el texto de entrada es sumamente ambiguo o contradictorio.
Conclusión
Llevamos un par de años asumiendo que el único camino para la IA era hacer modelos cada vez más grandes, lentos y locuaces.
Ver iniciativas como Jev demuestra que hay otro camino igual de valioso: especialización, contratos de tipos estrictos y optimización de latencia. Para quienes construimos software y nos preocupamos por la estabilidad de nuestros sistemas, que la IA empiece a adaptarse a nuestras normas de tipado —y no al revés— es una excelente noticia.
¿Qué opinas de este enfoque? ¿Crees que veremos más modelos renunciando al texto libre para integrarse mejor en backend, o crees que el tooling de structured outputs terminará siendo suficiente?